2026免费AI编程怎么选:DeepSeek V4 Pro/Kimi K2.6/Qwen3.8-Max深度对比
想要免费或低价用上顶级 AI 编程?本文从 SWE-Bench、LiveCodeBench、Terminal-Bench 等评测,以及价格、开源、上下文四个维度,横评 DeepSeek V4 Pro、Kimi、Qwen3.8-Max 三款 2026 旗舰编程模型,附 160 AI Router 统一接入实操,帮你一次选对。
2026 年想用 AI 写代码,早就不用花大钱了。国产开源模型在编程榜单上已经反超不少闭源旗舰,真正的难题变成了:DeepSeek、Kimi、通义千问这三家,到底选谁?
其实,没有绝对的“最强”,只有“最合适”。如果只认单一模型的免费编程综合分,DeepSeek V4 Pro 目前最亮眼;如果你跑的是多步 agent 编程或者图文混合的长任务,Kimi 更稳;如果你追官方开源的 Max 级新标杆,Qwen3.8-Max 是当下最值得关注的选择。下面用数据说话。
一、三款模型的核心评测
先看三款代表模型的核心评测:
1. DeepSeek V4 Pro 在 SWE-Bench Verified 上拿到 80.6%,是目前开源权重模型的最高分,LiveCodeBench(Pass\@1)高达 93.5%,Max 推理档下的 Codeforces 评分 3206 更是发布时所有模型中的最高纪录,关键是这些能力在 chat.deepseek.com 直接免费、没有付费档。
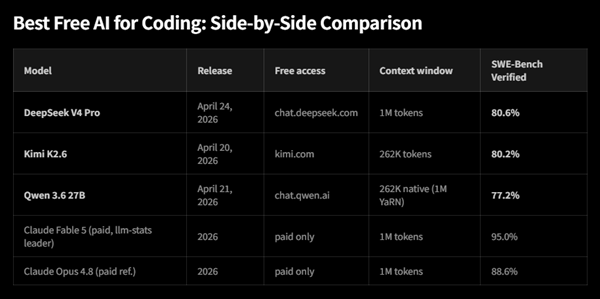
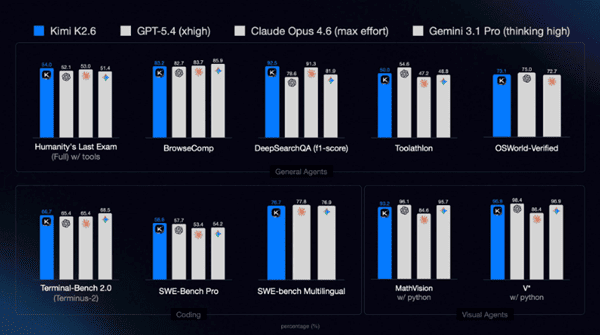
2. Kimi 这边,K2.6 主打 agentic coding,Terminal-Bench 2.0 拿到 66.7%;升级到 Kimi K3 后,2.8 万亿参数全量开源,Terminal-Bench 2.1 拿到 88.3(仅次于 GPT-5.6 Sol 的 88.8),Program Bench 77.8 排名第一。
3. 通义千问的 Qwen3.8-Max 把参数堆到 2.4 万亿,在 SWE-Bench Pro - Public 上拿到 67.70,是当前该榜单的第一,而且这是 Qwen 首次把 Max 级模型的权重全部开源。
以上数据来自不同的评测套件,SWE-Bench Verified、SWE-Bench Pro、DeepSWE、Terminal-Bench 彼此口径不同,不能简单比大小。更靠谱的做法是看它们各自在拿手维度上的位置,整理成下表:
| 维度 | DeepSeek V4 Pro | Kimi K2.6 / K3 | Qwen3.8-Max |
| 参数规模 | 1.6T 总参 / 49B 激活 | 2.8T(104B 激活) | 2.4T |
| 代码评测亮点 | SWE-Bench Verified 80.6%(开源最高)、LiveCodeBench 93.5% | K2.6 Terminal-Bench 2.0 66.7%;K3 Terminal-Bench 2.1 88.3 | SWE-Bench Pro - Public 67.70(当前第一) |
| Codeforces | 3206(Max 推理,发布时最高) | — | — |
| 上下文 | 百万级(1M) | 100 万 token | 长程任务优化 |
| 免费/开源 | 官网免费 + 开源 | 免费额度 + K3 全量开源 | 开源权重(Max 级首次) |
| 擅长场景 | 单模型全能编程 | Agent 长程、多模态 | 指标新标杆、官方开源 |
三、谁更适合你
1. DeepSeek V4 Pro 的定位是“免费里的天花板”,单模型、单任务下改代码、写算法、解 LeetCode 级难题都很顶,适合预算零、又想一步到位的新人,官网直接免费、没有 Plus 档,等于上车没有任何门槛。它的 API 输入价在第三方渠道折合约 1.74 美元每百万 token,性价比同样靠前。
2. Kimi 的强项在“让模型自己干一整套活”。K2.6 到 K3 这条线主打 agentic coding,会自己拆任务、调用终端、改完代码再跑测试,agent swarm 能扩展到数百个子任务,处理大型重构、跨文件改动时比单纯问答式的模型更省心。再加上 K3 原生多模态、100 万 token 上下文,如果你要让它边看设计图边写前端,或者啃一个几十万行的老仓库,Kimi 是三者里最合适的选择。
3. Qwen3.8-Max 的意义更多在于“开源行业里的新标杆”。它是阿里首次把 Max 这一档的权重开源,2.4 万亿参数,官方明确把编码、协作和长程任务作为主攻方向,还在 SWE-Bench Pro 上登顶,说明工程团队和想在本地自部署的人都能拿到顶级的编程能力,而不只是"能用 API 的那种开源"。
四、价格与开放方式对比
价格和开放方式再补一张表,帮你从“怎么低成本上车”的角度选:
| 模型 | 免费方式 | API 参考价 | 开源情况 |
| DeepSeek V4 Pro | chat.deepseek.com 免费 | 约 $1.74/M 输入 | 开源 |
| Kimi K2.6 / K3 | 官方免费额度 | 低价 API | K3 全量开源 |
| Qwen3.8-Max | — | 低价 API | 权重开源(首次) |
五、怎么统一接入
看完评测和价格,落到“怎么把这些模型都接进来”就很简单了。与其三家厂商各自注册、各自充值、各自维护密钥,不如用「160 AI Router」一个统一入口把 DeepSeek、Kimi、千问全收了,用 OpenAI 兼容格式一次接入、随时切换。操作起来就三步:
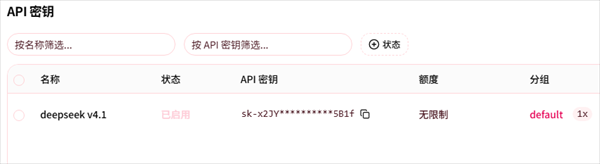
第一步:打开 160 AI Router 用手机号或邮箱注册登录,进入控制台的「API 密钥」页,点「创建密钥」,把生成的那串密钥复制下来,存到本地记事本里,避免泄露。
第二步:进入「模型广场」,在顶部筛选标签里勾选「低价」或「编程」,重点看每一行的输入价、输出价和缓存价,选中合适的模型后原样复制它的名字,并记下统一接入地址。
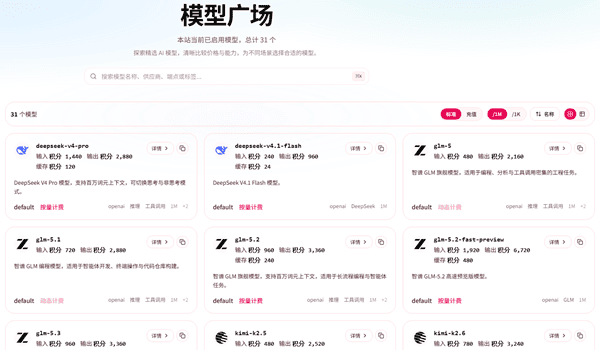
第三步:把统一地址、密钥、模型名三个值填进任何 OpenAI 兼容的编辑器或代码里,endpoint 换 base\_url、api\_key 换密钥、model 换模型名,其余逻辑几乎不用改,就能开始让模型帮你写代码了。
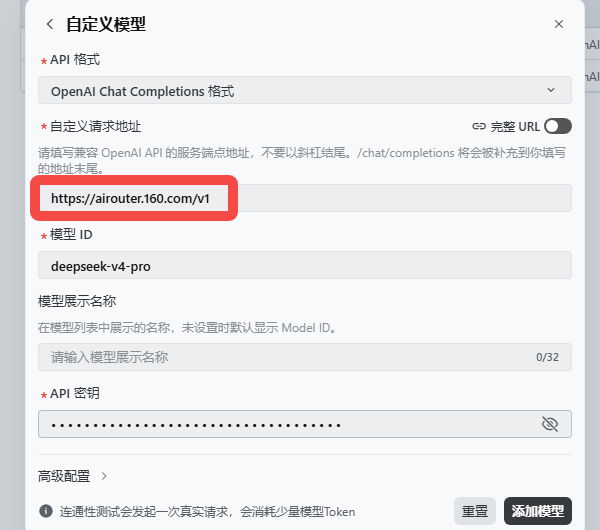
想换模型时,回到模型广场复制一个新名字替换 model 即可,连密钥都不用重新建。
常见问题
Q:免费模型写代码到底行不行?
A:主流评测里已经行得通了,DeepSeek V4 Pro 的 SWE-Bench 80.6% 甚至超过不少闭源付费模型,日常写脚本、改 bug、补测试完全够用。
Q:SWE-Bench、LiveCodeBench、Terminal-Bench 到底看哪个?
A:SWE-Bench 系列看你改真实开源项目的 bug 能力,LiveCodeBench 看竞赛式写题,Terminal-Bench 看它在终端里多步操作、循环修复的能力。日常写代码先看 SWE 和 LiveCodeBench,跑 agent 再重点看 Terminal-Bench。
Q:这三款能共用一个 API 地址吗?
A:能。接入「160 AI Router」后,DeepSeek、Kimi、千问共用同一个 base\_url,切模型只改 model 字段,密钥和地址都不用动,这也是它比分头注册三家最省事的地方。