智谱发布 GLM-5.3-FlashX:最高 200 tokens/s,API 价格公布
智谱发布 GLM-5.3-FlashX,最高生成速度达 200 tokens/s,API 同步开放。本文介绍 GLM-5.3-FlashX 的核心能力、API 价格、接入方法及常见问题,帮助开发者快速了解模型特点与使用方式。
2026年9月18日,智谱推出 GLM-5.3-FlashX,API 同步开放。新版本最高推理生成速度达到 200 tokens/s,相比 GLM-5.3-Flash 提升约 5 倍,主要面向对响应速度和生成效率有更高要求的开发者。
此次升级的重点是提升模型推理与生成效率,为实时对话、代码生成和 AI Agent 等应用提供更流畅的交互体验。下面介绍 GLM-5.3-FlashX 的核心能力、API 价格及具体接入方式。
一、GLM-5.3-FlashX 有哪些变化?
GLM-5.3-FlashX 是智谱 GLM-5.3-Flash 系列的高速版本。相比普通 Flash 版本,它更注重推理生成速度,适合需要频繁调用模型、快速返回结果的应用场景。
1. 最高生成速度达 200 tokens/s
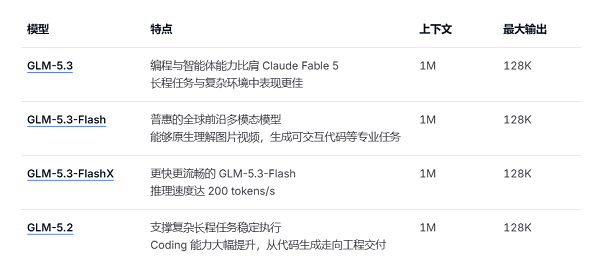
速度是 GLM-5.3-FlashX 的主要卖点。更快的 Token 生成速度能够缩短代码补全、文本生成和多轮对话的等待时间。不过,200 tokens/s 是官方公布的最高速度,实际表现还会受到输入长度、服务负载和网络环境等因素影响。
2. 支持多种内容输入
该系列支持文本、图片、视频和文件输入,输出为文本,可用于文档分析、内容理解和智能问答等任务。开发者可以根据业务需求,将模型集成到现有应用或自动化工作流中。
3. 支持长上下文处理
公开资料显示,该系列上下文窗口最高可达 100 万 Token,最大输出长度为 128K Token。长上下文能力有助于处理较长的文档、代码和多轮对话,但具体可用能力仍应以实际模型接口说明为准。
二、GLM-5.3-FlashX API 价格是多少?
模型的调用成本也是开发者选择服务时需要考虑的因素。按照公开的标准价格,GLM-5.3-FlashX 的输入价格为每百万 Token 2 元,输出价格为每百万 Token 7 元。
| 模型 | 输入价格/百万 Token | 输出价格/百万 Token |
| GLM-5.3-Flash | 0.8 元 | 2.8 元 |
| GLM-5.3-FlashX | 2 元 | 7 元 |
| GLM-5.3 | 8 元 | 28 元 |
从价格对比来看,FlashX 的输入和输出单价约为普通 Flash 版本的 2.5 倍,但低于 GLM-5.3 标准版本。
如果应用对响应速度要求较高,可以考虑 FlashX;如果主要关注调用成本,普通 Flash 版本可能更合适。实际费用还需要结合输入输出 Token 数量、缓存规则及平台最新计费政策计算。
三、GLM-5.3-FlashX API 怎么接入?
开发者可以通过智谱开放平台或兼容的 API 接入服务调用模型。如果需要在不同国产大模型之间切换,也可以考虑使用 160 AI Router 统一管理 API 配置。
方法一:通过 160 AI Router 接入
160 AI Router 提供统一 API 接入方式,适合希望集中管理多个模型密钥、减少重复配置的开发者。接入前,需要先确认模型广场是否已经上架 GLM-5.3-FlashX。
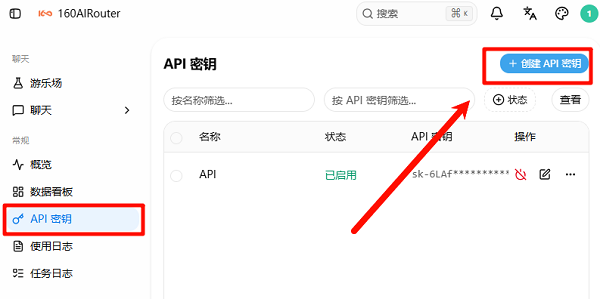
1. 打开 160 AI Router (https://airouter.160.com/),进入控制台,点击「API密钥」→「创建API密钥」,填写名称并创建,随后复制密钥。
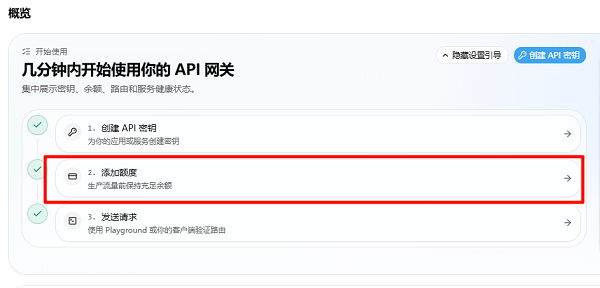
2. 在控制台找到「添加额度」,根据自己的使用需求选择合适的额度或套餐。完成后,检查账户是否具备可用额度,避免调用时因余额不足而失败。
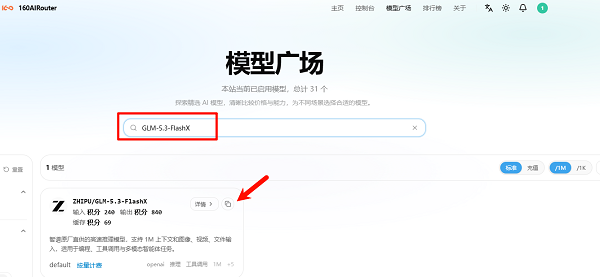
3. 在「模型广场」搜索 GLM-5.3-FlashX,查看模型是否可用、对应价格及准确的模型名称。然后根据页面提示添加调用额度。
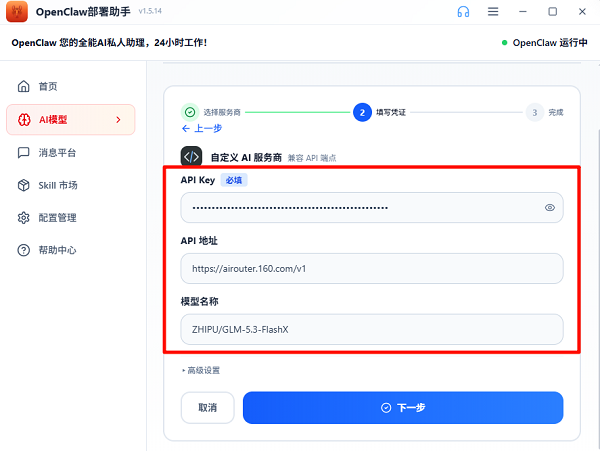
4. 打开支持自定义 API 的 AI 应用、开发工具或 Agent 工具,如“Openclaw部署助手”找到模型服务商或 API 配置页面,填写以下信息:
Base URL:https://airouter.160.com/v1
API Key:填入此前创建的 API 密钥
Model:填入模型广场显示的准确模型名称
5. 保存后发送测试消息,确认模型能够正常返回结果。
方法二:通过智谱开放平台接入
如果希望直接使用智谱提供的模型服务,可以进入智谱开放平台,创建 API Key,并按照官方 API 文档配置模型名称、接口地址和请求参数。完成配置后,通过测试请求确认接口可以正常返回结果。
这种方式适合直接使用智谱原厂服务的开发者;如果项目需要在多款模型之间切换,则可以根据实际需求评估统一 API 接入方案。
四、常见问题解答
1. GLM-5.3-FlashX 的最高生成速度是多少?
GLM-5.3-FlashX 官方公布的最高推理生成速度为 200 tokens/s,较 GLM-5.3-Flash 提升约 5 倍。实际速度会受到请求长度、服务负载等因素影响。
2. GLM-5.3-FlashX API 怎么收费?
公开标准价格为输入每百万 Token 2 元、输出每百万 Token 7 元。实际调用费用取决于 Token 消耗量及平台最新计费规则,使用前建议核对官方价格。
3. GLM-5.3-FlashX 可以通过 160 AI Router 接入吗?
可以先进入 160 AI Router 的「模型广场」搜索 GLM-5.3-FlashX,确认模型已开放后,创建 API 密钥、添加调用额度,并配置 API 地址和模型名称。具体可用情况以平台页面为准。