2026百万上下文长文本模型怎么选:DeepSeek-V4-Pro/Kimi K3/GLM-5.2
百万上下文长文本模型怎么选?本文从参数架构、上下文能力、多模态与编程表现、价格四个维度,对比 DeepSeek-V4-Pro、Kimi K3 与 GLM-5.2 三款旗舰模型,附按场景选型建议与价格对照表,帮你一次选对。
进入 2026 年,国产大模型全面迈入“百万上下文”时代——一整本长篇小说、一整个中型代码仓库、几百份研报,都能一次性塞进上下文里处理。但选项一多,选型反而更难:同时支持百万 token 上下文的三款旗舰 DeepSeek-V4-Pro、Kimi K3、GLM-5.2,参数、能力、价格各不相同。这篇文章从架构、能力、价格三个层面做横向对比,把“长文本模型怎么选”一次说清。
一、三款模型核心参数对比
| 维度 | DeepSeek-V4-Pro | Kimi K3 | GLM-5.2 |
| 参数规模 | 1.6T 总参 / 49B 激活(MoE) | 2.8T 总参(MoE) | 旗舰基座(MoE) |
| 上下文窗口 | 百万级(1M) | 100 万 token | 1M(真正可用) |
| 模态 | 文本(推理旗舰) | 多模态(原生视觉) | 纯文本(编程旗舰) |
| 核心能力 | 复杂推理、代码、长文本解析 | 长程编程、知识工作、视觉 | 长流程编程、项目级工程 |
| 思考模式 | 可切换思考/非思考 | 可切换高强度思考 | 高/极致推理档 |
| 开源协议 | 开源 | 开源 | 开源(MIT) |
二、三款模型分别强在哪
1. DeepSeek-V4-Pro
DeepSeek-V4 系列主打“百万上下文普惠”,Pro 版总参数 1.6T、激活 49B,在 Agent 能力、世界知识与推理性能上位居国内与开源前列,复杂推理、专业代码与长文本深度解析是强项,适合高阶科研、复杂办公与深度智能代理场景。它支持切换思考与非思考模式,需要深推理时开思考、追求响应速度时省 token。
2. Kimi K3
Kimi K3 是月之暗面迄今最强旗舰,参数高达 2.8 万亿,是全球首个开源的 3 万亿级别模型,基于 Kimi Delta Attention 混合线性注意力与注意力残差技术构建,原生支持视觉理解并拥有 100 万 token 上下文。它是三款里唯一原生多模态的模型,图文混合的长任务只能选它。
3. GLM-5.2
智谱把 GLM-5.2 定位为“面向长任务时代的旗舰模型”,核心卖点是“真正可用的 1M 上下文”——不是能“接收”长输入,而是能稳定承载项目级工程上下文。它引入 IndexShare 技术,把长上下文下每 token 计算量降低约 2.9 倍,让长上下文调用更省钱,并采用 MIT 开源协议、Day 0 运行在国产算力上。
三、价格对比
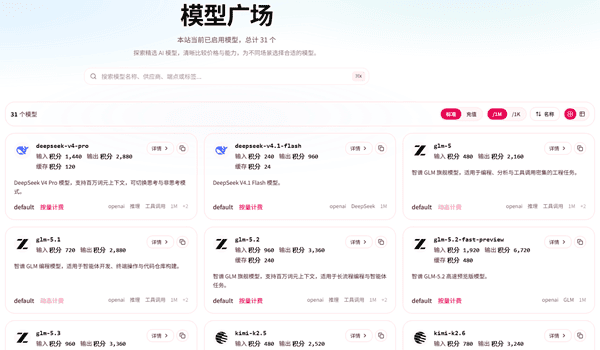
除了看能力,选型还要看“接入和计费的成本”。这三款旗舰虽然分属 DeepSeek、月之暗面、智谱三家厂商,但通过160 AI Router这样一个统一入口,就能一次性接入、随时切换,不用为每家分别注册、充值和维护密钥。在它的模型广场里,三款模型均以"积分"计费、按 1M token 计价,当前价格如下:
| 模型 | 输入 | 输出 | 缓存输入 |
| deepseek-v4-pro | 1,440 积分 | 2,880 积分 | 120 积分 |
| kimi-k3 | 2,400 积分 | 12,000 积分 | 240 积分 |
| glm-5.2 | 960 积分 | 3,360 积分 | 240 积分 |
如果你也想把这三款模型“一个入口”管起来,操作其实只有三步:
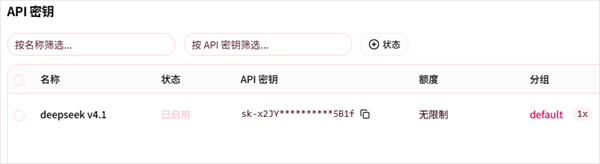
1. 创建密钥:登录 160 AI Router 后,进入控制台的「API 密钥」页新建一把密钥,密钥只保存在服务端,不要写进前端代码或公开仓库。
2. 选模型、拿名称:打开「模型广场」,搜索 deepseek-v4-pro、kimi-k3 或 glm-5.2,查看实时价格与能力标签,复制对应模型名。
3. 替换调用地址:在你的应用里,把 OpenAI 兼容的 Base URL 改成 https://airouter.160.com/v1 ,再填入密钥和模型名即可。比如原本调用 OpenAI SDK 的代码,只需把 base_url 和 model 两个参数替换一下,就能无缝切到任意一家国产旗舰,切换成本几乎为零。
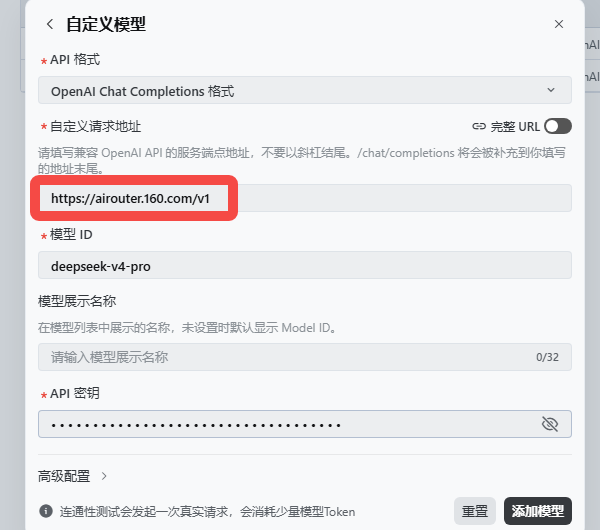
这样配置后,长文本、编程和多模态三种场景就都覆盖在一个账单、一套密钥里,配合使用日志随时查看每次调用与消耗,成本更可控。
四、怎么选:按场景给结论
① 纯文本长文 / 复杂推理 → DeepSeek-V4-Pro:推理强、可切换思考、输入输出均衡。
② 图文结合的长任务(图表、文档、视觉理解)→ Kimi K3:三者中唯一原生多模态。
③ 长流程编程 / 项目级代码仓库 → GLM-5.2:1M 上下文“真正可用” + IndexShare 省钱。
五、常见问题(FAQ)
Q:百万上下文和大参数,哪个更重要?
A:看任务类型。读长文、跑长代码仓库时,上下文窗口是硬门槛;但“装得下”不等于“用得好”,推理与工程能力同样关键。三款都把两者做到了旗舰级,差别主要在定位。
Q:Kimi K3 输出价贵那么多,值得吗?
A:纯文本长文,GLM-5.2 或 DeepSeek-V4-Pro 性价比更高;但若要处理图文混合、需要原生视觉的长任务,K3 的多模态能力当下没有同价位替代,贵出的部分对应的是能力上限。
Q:这三款模型能从一个入口统一调用吗?
A:能。以160 AI Router为例,它把三家国产模型的接入、密钥与计费统一收口到一个 OpenAI 兼容接口,只需在模型广场复制模型名、换一个 base_url 就能随时切换,不用为每家厂商单独接入,还能集中查看用量与账单。
Q:长文本任务怎么控制成本?
A:优先命中缓存输入(缓存价通常远低于输入价),善用“非思考 / 低推理档”省 token,再结合统一网关的用量看板监控消耗,避免长上下文场景的隐性超支。